
- 数字报

- 小程序
- 公众号

本报记者 孙庆阳
随着2026年全国两会明确提出建设超大规模智算集群与算电协同新基建工程,如何构建支撑未来十万卡级智算集群的核心基础设施,已成为业界焦点。3月12日,中科曙光宣布实现国产高端原生RDMA技术重大突破,正式发布首款全栈自研400G无损高速网络——scaleFabric。该产品基于原生RDMA架构,从底层的112G SerDes IP、硬件设备到上层的管理软件实现100%自主研发,填补了国内数据中心高速网络领域的空白。
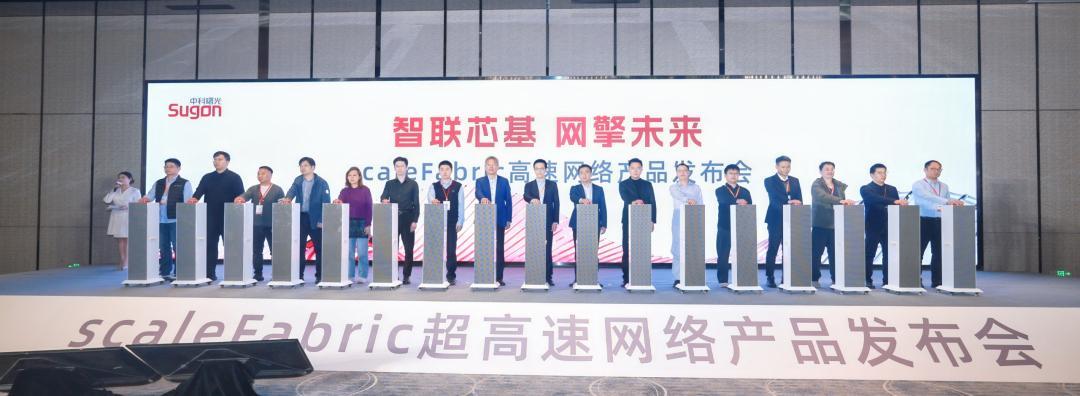
在发布活动现场,中科曙光高级副总裁李斌首先阐释了该产品的战略定位。他指出,scaleFabric并非孤立存在,而是与芯片、存储共同构成算力基础设施的三大核心组件。随着模型参数的爆炸式增长,业界共识已从万卡集群向十万卡级迈进。然而,规模扩张的核心瓶颈并非计算节点本身,而在于互联系统。“从万卡到十万卡,最核心的挑战在于保证系统效率的可扩展性。”他还强调,大规模训练要求高度协同,网络可靠性的重要性因此被推至前所未有的高度。
北京科技大学计算机与通信学院储根深,作为早期用户代表,从应用视角剖析了当前高性能互联网络的难点。他认为,挑战主要体现在两个维度:一是生态建设,尽管英伟达及其InfiniBand(IB)生态已非常成熟,但国产体系需要更大的环境支持来发展壮大;二是十万卡级的组网技术,即如何将海量节点高效协同工作。“这种突破对于高校及科研机构的意义在于,当硬件将通信性能补齐后,应用软件对计算资源的利用率有望从当前的百分之六七十提升至百分之八九十。”
针对市场关心的技术指标与竞争格局,中科曙光高速网络互联产品部总工程师万伟透露了具体细节:scaleFabric目前能够实现低至0.9微秒的通信延时,这一指标已与英伟达CX7处于同一水平线,是网卡性能上限的体现。这一突破源于团队在物理层和工艺上的长期攻关,过程中经历了诸多艰辛。
谈及产品对产业的实际影响,李斌表示,公司的发展理念既要“技术顶天”,服务于未来十万卡的大规模系统,也要“产业化落地”,实现广泛的适配与普惠。他强调,当前在计算领域面临“卡脖子”问题的同时,网络领域的自主可控同样迫在眉睫。他进一步分析,市场空间是巨大的,相较于以CPU为核心的传统数据中心,以GPU为核心的新一代智算中心对高速网络端口的用量提升了10到20倍。面对国际厂商在IB和RoCE路线上的强势地位,中科曙光选择了一条更为开放的路径。李斌坦言,“尽管英伟达体系构建了闭环生态,但其底层协议亦有开放之处。我们的策略是继承开放的部分,同时力求打开其在商业与技术上的绑定。”
在生态构建层面,曙光信息产业(北京)有限公司副总裁李柳补充道,技术推出之后如何应用,关键在于标准化与生态适配。光合组织已成立相关工作组,未来将以开放姿态联合国内合作伙伴,推动三件事:建立相关标准,避免无效路径;打造生态适配系统,通过用户反馈打磨产品;联合科研力量,构建产学研用体系。“未来万卡、十万卡有可能是常态化的算力集群。随着模型参数进入万亿级,市场对集群的性能、可靠性、带宽以及运维成本都提出了指数级增长的要求。”
对于国家正在推进的全国一体化算力网建设,李斌认为目前仍处于多方向探索的阶段。他透露,中科曙光在超算互联网上的实践已被国家数据局纳入全国一体化算力网试点。未来的算力网不应仅仅是提供冷冰冰的接口,而应更贴近用户的实际问题。他设想,通过接入AI智能体,科学家只需描述宏观问题,系统便能自动拆解任务、调用资源、汇总结果,甚至辅助撰写论文。
面对“国产化何时能突破封锁”这一现状,储根深认为,从超算到智算,应用需求始终存在,只是随着硬件发展,计算从“粗糙”走向“精细”。李斌则补充,构建万卡乃至十万卡级系统,核心难点在于两点:一是通过可靠性解决“能否稳定工作”的问题,二是通过软硬件协同调优解决“效率能否发挥”的问题。这需要一支同时懂芯片、懂系统拓扑、懂网络结构,并能将其与算法深度耦合的团队。
(企业供图)
友情链接: 政府 高新园区合作媒体
Copyright 1999-2026 taptap软件qs9988.com All Rights Reserved.京ICP备14033264号-5
电信与信息服务业务经营许可证060344号主办单位:点点手机应用下载
